OpenAI met en place un filigrane pour les textes générés par l’IA dans l’UE
OpenAI a annoncé qu’il commencera à ajouter un filigrane invisible aux textes générés par ChatGPT et Codex au sein de l’Union européenne, afin de se conformer à la loi européenne sur l’IA, avec effet immédiat. Cette initiative fait suite aux exigences de transparence qui sont entrées en vigueur le 2 août, obligeant les entreprises d’IA à marquer le contenu généré par l’IA de manière détectable par d’autres systèmes.
La fonctionnalité de filigrane sera déployée progressivement auprès des utilisateurs éligibles de ChatGPT et Codex dans tous les plans de l’UE au cours des prochaines semaines. Pour les développeurs utilisant l’API d’OpenAI à l’échelle mondiale, l’option d’activer le filigrane pour des modèles sélectionnés est disponible immédiatement, bien qu’elle soit désactivée par défaut. OpenAI a précisé qu’il ne rend pas le filigranage de texte une fonctionnalité standard dès le départ.
Cette technique de filigranage n’implique pas de symbole visible ; elle influence subtilement les choix de mots du modèle, créant un motif invisible que les systèmes de détection peuvent reconnaître. Il est important de noter que, puisque le filigrane est intégré dans le texte lui-même, il reste intact lorsqu’il est copié ou collé. OpenAI a souligné que le filigrane n’identifie pas l’utilisateur et n’a indiqué aucune modification significative des performances du modèle avec le filigrane activé.
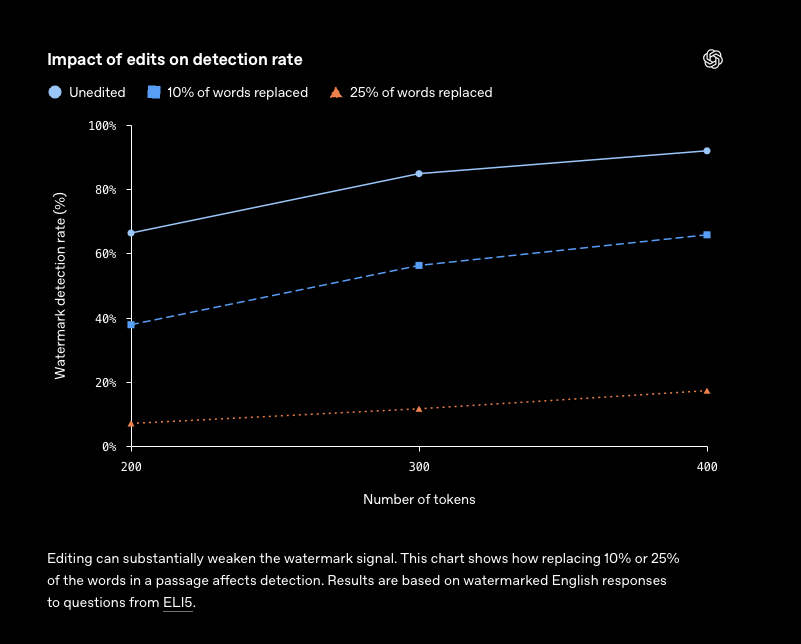
Accompagnant cette annonce, un rapport technique sur la méthode de filigranage, nommée textGrain, coécrit avec des chercheurs de l’Université de Pennsylvanie et de Yale, a été publié. Ce rapport détaille la méthodologie utilisant une clé secrète pour ajuster les prévisions du mot suivant et démontre comment plusieurs modifications peuvent aider les détecteurs à identifier le contenu généré par l’IA.
Des tests réalisés par OpenAI suggèrent que le filigrane peut être atténué par des modifications. Par exemple, remplacer 10 % des mots par des synonymes a réduit les taux de détection d’environ 92 % à 66 %. La société a noté que les passages de texte plus courts, les réponses mathématiques et le contenu traduit sont intrinsèquement plus difficiles à détecter.
OpenAI a choisi de limiter initialement l’accès aux détecteurs aux chercheurs et organisations d’experts approuvés, invoquant le besoin d’évaluer la fiabilité et le déploiement responsable. Ils ont averti que l’absence d’un filigrane ne confirme pas nécessairement l’authorship humain, car d’autres facteurs—tels que la brièveté ou des modifications étendues—pourraient expliquer cette divulgation.
Les remarques de l’entreprise soulignent que, bien que les filigranes puissent suggérer qu’un passage a été généré ou traité par un système d’OpenAI, ils ne quantifient pas l’étendue de l’implication ou de la créativité humaine dans la production.
Cette annonce suit un engagement similaire de la part d’Anthropic, qui a promis de filigraner les résultats de son modèle d’IA, Claude, à travers le monde. Cette décision antérieure a suscité des critiques de la part de certains utilisateurs qui affirmaient qu’ils apportaient une contribution substantielle alors que Claude fonctionnait simplement comme un outil.
OpenAI avait précédemment développé une fonctionnalité de filigranage de texte, mais avait retardé son lancement en raison de préoccupations selon lesquelles les utilisateurs pourraient se tourner vers des plateformes concurrentes ne mettant pas en œuvre de telles mesures, comme l’a rapporté le Wall Street Journal en 2024.
OpenAI, ainsi que des leaders du secteur tels qu’Anthropic, Google, Meta et Microsoft, a convenu de se conformer au code de pratique de l’UE concernant le contenu généré par l’IA, soulignant un effort collectif pour renforcer la responsabilité dans le déploiement de l’IA.